La question se teste en dix minutes — à condition de ne pas commettre l’erreur qui fausse le résultat de tout le monde. Et si la réponse est non, les causes sont identifiables, et pour la plupart corrigeables.
Pourquoi le test que fait tout le monde donne un faux résultat
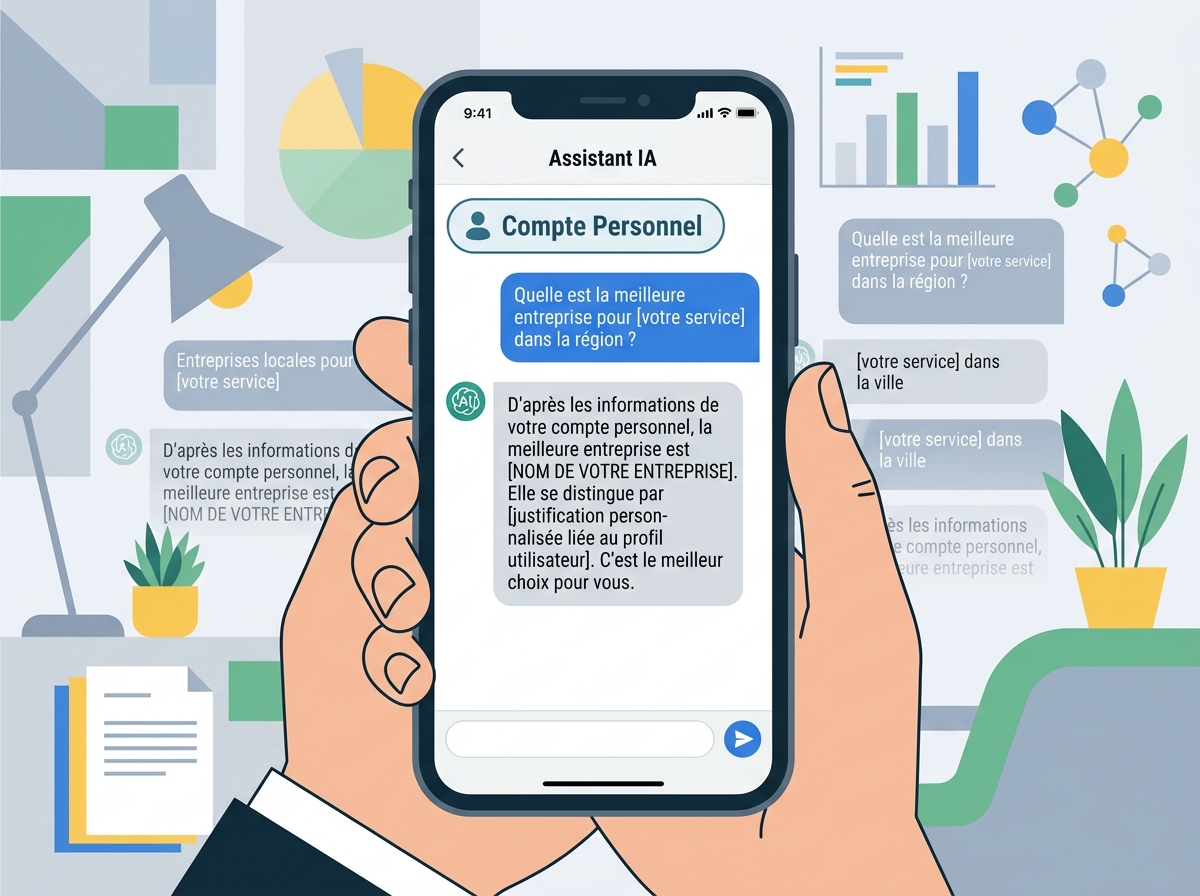
Un client vous demande de plus en plus souvent s’il « sort dans ChatGPT ». La question est légitime : quand un acheteur demande conseil à un assistant plutôt que de parcourir dix liens, être absent de la réponse revient à ne pas exister pour ce parcours.
Mais la manière dont la plupart des gens vérifient produit une réponse fausse, et rassurante.
Erreur 1 — tester depuis son propre compte
Les assistants personnalisent : ils tiennent compte de l’historique de conversation, parfois de la mémoire du compte, et de la localisation. Vous avez déjà parlé de votre entreprise à cet assistant, ne serait-ce qu’en écrivant son nom dans la question. Il vous la ressort.
Vous concluez que vous êtes cité ; un prospect qui n’a jamais entendu parler de vous obtiendra tout autre chose.
Erreur 2 — demander « connais-tu telle entreprise ? »
Un modèle répond presque toujours oui à cette forme, parce qu’elle l’invite à confirmer. La question qui compte est celle que pose réellement un acheteur : « quel prestataire me recommandes-tu pour tel besoin, dans telle ville ».
Le test qui donne un résultat exploitable
- Ouvrez une conversation neuve, en navigation privée, déconnecté de tout compte
- Posez la question du point de vue de l’acheteur, sans jamais nommer l’entreprise
- Formulez cinq à dix variantes : besoin, métier, ville, contrainte de budget, urgence
- Répétez sur au moins trois assistants — les réponses divergent fortement de l’un à l’autre
- Relevez qui est cité à votre place, et d’où la réponse tire ses sources quand elle les affiche
- Recommencez à quelques jours d’intervalle : une réponse unique n’est pas une mesure
Ces modèles ne sont pas déterministes : deux exécutions de la même question peuvent produire deux réponses différentes. Conclure sur un seul essai revient à tirer à pile ou face et à en déduire une tendance.
Une mesure sérieuse répète, sur plusieurs formulations et plusieurs jours, et raisonne en fréquence de citation plutôt qu’en oui ou non.
Ce que la recherche identifie comme les vrais leviers
Les travaux de référence sur le sujet — Aggarwal et ses coauteurs, « GEO: Generative Engine Optimization », KDD 2024, arXiv 2311.09735 — ont mesuré l’effet de différentes modifications de contenu sur la visibilité dans les réponses génératives. Deux résultats méritent d’être connus.
Le premier : les meilleures méthodes améliorent la visibilité jusqu’à environ 41 %, et parmi les plus efficaces figurent l’ajout de citations et l’ajout de statistiques. Une page qui cite ses sources et porte des chiffres vérifiables est significativement plus reprise qu’une page qui affirme.
Le second, plus contre-intuitif : le simple fait d’adopter un ton d’autorité, sans rien changer d’autre, ne produit pas d’effet significatif.
Écrire « nous sommes les experts » ne fait pas citer. Écrire « selon telle source, tel chiffre » fait citer.
Les causes fréquentes d’absence, dans l’ordre où les traiter
- Aucune page ne répond à la question telle qu’un acheteur la pose — vous parlez de votre offre, il parle de son problème
- Vos pages affirment sans citer : ni source, ni chiffre, ni date, donc rien à reprendre
- L’entreprise n’est décrite nulle part ailleurs que sur son propre site — les assistants s’appuient largement sur des sources tierces
- Les informations sont incohérentes d’une plateforme à l’autre : le modèle ne sait pas quelle entité il manipule
- Trop peu d’avis, ou des avis anciens : le signal de réputation est faible
- Des pages que les robots lisent mal — une page inaccessible n’est jamais une source
Mesurer ne fait gagner aucune citation
Ces causes se corrigent, mais aucune ne se corrige en écrivant « nous sommes cités par l’IA » sur sa page d’accueil. Elles demandent du travail sur le contenu, sur la cohérence des informations, et sur la présence hors de son propre site.
C’est un chantier de plusieurs semaines, dont l’effet se mesure exactement comme le reste : une mesure avant, une fenêtre d’observation, une mesure après.
Un tableau de bord vous apprend que vous n’êtes pas cité ; il ne réécrit pas vos pages, ne corrige pas votre fiche et ne collecte pas vos avis. La mesure est nécessaire, elle n’est jamais suffisante.